Domain wetteifer.de kaufen?
Wir ziehen mit dem Projekt
wetteifer.de um.
Sind Sie am Kauf der Domain
wetteifer.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain wetteifer.de kaufen?
Wie können Trainingsdaten effektiv genutzt werden, um die Leistung von KI-Modellen zu verbessern?
Trainingsdaten sollten vielfältig und repräsentativ sein, um ein breites Spektrum an Informationen abzudecken. Durch kontinuierliches Feedback und Anpassung der Trainingsdaten können KI-Modelle stetig verbessert werden. Zudem ist es wichtig, die Qualität der Trainingsdaten zu überwachen und sicherzustellen, dass sie aktuell und relevant sind. **
Gibt es ein alternatives Programm zur Auswertung von Trainingsdaten?
Ja, es gibt verschiedene alternative Programme zur Auswertung von Trainingsdaten. Ein Beispiel ist "Strava", eine beliebte Plattform für Sportler, auf der sie ihre Aktivitäten aufzeichnen und analysieren können. Eine andere Option ist "TrainingPeaks", das speziell für Ausdauersportarten entwickelt wurde und detaillierte Trainingsanalysen und -planung bietet. Es gibt auch viele andere spezialisierte Apps und Programme, je nach den individuellen Bedürfnissen und Vorlieben des Nutzers. **
Ähnliche Suchbegriffe für Trainingsdaten
Top-Angebote
Produkte zum Begriff Trainingsdaten:
-
Buki Murmeln Herausforderung KugelbahnSetze die Murmelbahn zusammen, suche dir eine Murmel in der Farbe deiner Wahl aus und lege sie auf die Startlinie neben die gegnerischen Murmeln. Beobachte, wie die Murmel durch die Bahn saust und geschickt den Fallen ausweicht. Benutze den kleinen Blasebalg, um die Murmel schneller voranzutreiben oder abzubremsen. Wer wird dieses Rennen gewinnen? Kompatibel mit Buki PM852 und PM854. Farbig illustrierte Anleitung mit 5 Konstruktionsvorschlägen. Ab 7 Jahren.36,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Vorbild - Austausch - Konkurrenz, Fachbücher von Werner ParaviciniDas Fachbuch "Vorbild - Austausch - Konkurrenz" von Werner Paravicini bietet eine tiefgehende Analyse der Beziehungen zwischen Fürsten und Höfen im historischen Kontext. Es beleuchtet, wie diese Akteure sich gegenseitig beeinflussten, Standards setzten und sich gleichzeitig voneinander abgrenzen wollten. Anhand von 20 Beiträgen international anerkannter Wissenschaftler wird untersucht, welche Rolle Vorbilder, Austausch und Konkurrenz in der Selbstdarstellung der Fürsten spielten. Die thematischen Sektionen des Buches bieten Einblicke in die Dynamiken des Wissens und der Wahrnehmung zwischen den Herrschern sowie die Komplexität der Beziehungen zwischen Freund und Feind. Dieses Werk eröffnet neue Perspektiven und Forschungsfelder in der Geschichtswissenschaft und ist ein wertvoller Beitrag zur Diskussion über Macht und Einfluss in der Geschichte.69,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
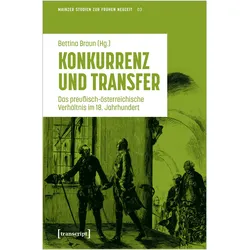
Konkurrenz und Transfer, Fachbücher von Bettina BraunDas Verhältnis zwischen Preussen und Österreich im 18. Jahrhundert wurde häufig als konfrontativ oder gar als Systemgegensatz geschildert. Die Beiträger des Bandes gehen hingegen von Konkurrenz als einem dynamischen und flexiblen Konzept aus. Sie legen dar, wie beide Mächte in der monarchischen Herrschaftspraxis, im Militär, in der Finanzverwaltung, der Religionspolitik und im Volksschulwesen Konzepte des Gegners oder Dritter übernahmen oder unabhängig und parallel zu ähnlichen Lösungen fanden. Ausserdem zeigt der Band, auf welche Weise Österreich und Preussen in verschiedenen Bereichen der Reichspolitik und in ausgewählten Territorien miteinander konkurrierten.55,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Wie können Trainingsdaten effektiv genutzt werden, um maschinelles Lernen zu verbessern? Was sind die besten Methoden zur Beschaffung und Verwaltung von Trainingsdaten für KI-Systeme?
Trainingsdaten können effektiv genutzt werden, indem sie in ausreichender Menge und Vielfalt gesammelt werden, um das Modell zu trainieren. Zudem ist es wichtig, die Daten zu bereinigen und zu kennzeichnen, um sicherzustellen, dass sie von hoher Qualität sind. Schließlich sollte das Modell regelmäßig mit neuen Daten aktualisiert werden, um die Leistung kontinuierlich zu verbessern. Die besten Methoden zur Beschaffung und Verwaltung von Trainingsdaten für KI-Systeme sind die Nutzung von Datenbanken, Crowdsourcing-Plattformen und Web-Scraping-Tools, um eine große Menge an Daten zu sammeln. Zudem ist es wichtig, die Daten zu kategorisieren, zu kennzeichnen und zu **
-
Wie können Trainingsdaten effektiv genutzt werden, um maschinelles Lernen zu verbessern?
Trainingsdaten sollten vielfältig und repräsentativ sein, um das Modell auf verschiedene Szenarien vorzubereiten. Zudem ist es wichtig, die Daten vorab zu bereinigen und zu normalisieren, um Rauschen zu reduzieren. Schließlich sollte das Modell regelmäßig mit neuen Daten aktualisiert und überwacht werden, um die Genauigkeit und Leistung kontinuierlich zu verbessern. **
-
Wie beeinflusst das Splitten von Trainingsdaten die Leistung von maschinellen Lernalgorithmen in Bezug auf Genauigkeit und Overfitting?
Das Splitten von Trainingsdaten in Trainings- und Testsets ermöglicht es, die Leistung eines maschinellen Lernalgorithmus zu bewerten, indem das Modell auf den Trainingsdaten trainiert und auf den Testdaten getestet wird. Dies hilft, die Genauigkeit des Modells zu bewerten, da es auf Daten getestet wird, die es zuvor nicht gesehen hat. Außerdem hilft das Splitten der Daten, Overfitting zu vermeiden, da das Modell auf unabhängigen Testdaten getestet wird, was dazu beiträgt, sicherzustellen, dass das Modell nicht zu stark an die Trainingsdaten angepasst ist. Durch das Splitten der Daten können wir also die Genauigkeit des Modells bewerten und sicherstellen, dass es nicht überangepasst ist. **
-
Wie beeinflusst das Splitten von Trainingsdaten die Leistung von maschinellen Lernalgorithmen in Bezug auf Genauigkeit und Overfitting?
Das Splitten von Trainingsdaten in Trainings- und Testsets ermöglicht es, die Leistung eines maschinellen Lernalgorithmus zu bewerten, indem die Genauigkeit auf einem unabhängigen Datensatz gemessen wird. Dies hilft, Overfitting zu vermeiden, da der Algorithmus auf Daten getestet wird, die er während des Trainings nicht gesehen hat. Ein zu kleines Trainingsset kann zu Overfitting führen, während ein zu großes Trainingsset zu einer schlechten Generalisierung führen kann. Das richtige Verhältnis zwischen Trainings- und Testdaten ist entscheidend, um die Leistung des Algorithmus zu optimieren. **

Was sind Trainingsdaten und warum sind sie für maschinelles Lernen so wichtig?
Trainingsdaten sind Beispieldaten, die verwendet werden, um ein Modell im maschinellen Lernen zu trainieren. Sie bestehen aus Eingabe- und Zielvariablen, die dem Modell helfen, Muster zu erkennen und Vorhersagen zu treffen. Ohne Trainingsdaten könnte das Modell keine Zusammenhänge lernen und wäre nicht in der Lage, genaue Vorhersagen zu treffen. **
"Was sind Trainingsdaten und wie werden sie in der künstlichen Intelligenz verwendet?"
Trainingsdaten sind Daten, die verwendet werden, um ein künstliches Intelligenzmodell zu trainieren. Sie bestehen aus Eingabe- und entsprechenden Ausgabedaten, die dem Modell helfen, Muster zu erkennen. Die Trainingsdaten werden verwendet, um das Modell zu optimieren und es in die Lage zu versetzen, Vorhersagen oder Entscheidungen zu treffen. **
Top-Angebote
Produkte zum Begriff Trainingsdaten:
-
Macht und Rivalität in Briefen, Fachbücher von Paolo RaileBriefe waren am Beginn des 20. Jahrhunderts, der Entstehungszeit der grossen tiefenpsychologischen Schulen wie der Psychoanalyse oder der Individualpsychologie, ein weit verbreitetes und etabliertes Fernkommunikationsmittel. Darin wurden nicht nur fachliche Themen erörtert, sondern auch Machtverhältnisse verhandelt und über Rivalen hergezogen. In diesem Buch stehen die Sendschreiben der damaligen Tiefenpsycholog*innen im Zentrum der Aufmerksamkeit, denn gerade dort werden Aussagen über Konfliktpartner*innen oder Machtstrukturen unverblümt mitgeteilt, die ansonsten in keinem wissenschaftlichen Aufsatz oder Buch in dieser Klarheit zu finden sind. Neben der Rivalität zwischen dem Freudschen Hühnerstall und der Adlerschen Affenbande werden auch die Konflikte um das Zentralblatt für Psychoanalyse, die Frage der Laienanalyse oder das geheime Komitee detailliert aufgearbeitet. Den Abschluss bildet ein Fazit, das den Bogen bis in die Gegenwart und zu den heutigen Rivalitäten an universitären und ausseruniversitären wissenschaftlichen Organisationen spannt.39,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Buki Murmeln Herausforderung KugelbahnSetze die Murmelbahn zusammen, suche dir eine Murmel in der Farbe deiner Wahl aus und lege sie auf die Startlinie neben die gegnerischen Murmeln. Beobachte, wie die Murmel durch die Bahn saust und geschickt den Fallen ausweicht. Benutze den kleinen Blasebalg, um die Murmel schneller voranzutreiben oder abzubremsen. Wer wird dieses Rennen gewinnen? Kompatibel mit Buki PM852 und PM854. Farbig illustrierte Anleitung mit 5 Konstruktionsvorschlägen. Ab 7 Jahren.36,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Vorbild - Austausch - Konkurrenz, Fachbücher von Werner ParaviciniDas Fachbuch "Vorbild - Austausch - Konkurrenz" von Werner Paravicini bietet eine tiefgehende Analyse der Beziehungen zwischen Fürsten und Höfen im historischen Kontext. Es beleuchtet, wie diese Akteure sich gegenseitig beeinflussten, Standards setzten und sich gleichzeitig voneinander abgrenzen wollten. Anhand von 20 Beiträgen international anerkannter Wissenschaftler wird untersucht, welche Rolle Vorbilder, Austausch und Konkurrenz in der Selbstdarstellung der Fürsten spielten. Die thematischen Sektionen des Buches bieten Einblicke in die Dynamiken des Wissens und der Wahrnehmung zwischen den Herrschern sowie die Komplexität der Beziehungen zwischen Freund und Feind. Dieses Werk eröffnet neue Perspektiven und Forschungsfelder in der Geschichtswissenschaft und ist ein wertvoller Beitrag zur Diskussion über Macht und Einfluss in der Geschichte.69,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie können Trainingsdaten effektiv genutzt werden, um die Leistung von KI-Modellen zu verbessern?
Trainingsdaten sollten vielfältig und repräsentativ sein, um ein breites Spektrum an Informationen abzudecken. Durch kontinuierliches Feedback und Anpassung der Trainingsdaten können KI-Modelle stetig verbessert werden. Zudem ist es wichtig, die Qualität der Trainingsdaten zu überwachen und sicherzustellen, dass sie aktuell und relevant sind. **
-
Gibt es ein alternatives Programm zur Auswertung von Trainingsdaten?
Ja, es gibt verschiedene alternative Programme zur Auswertung von Trainingsdaten. Ein Beispiel ist "Strava", eine beliebte Plattform für Sportler, auf der sie ihre Aktivitäten aufzeichnen und analysieren können. Eine andere Option ist "TrainingPeaks", das speziell für Ausdauersportarten entwickelt wurde und detaillierte Trainingsanalysen und -planung bietet. Es gibt auch viele andere spezialisierte Apps und Programme, je nach den individuellen Bedürfnissen und Vorlieben des Nutzers. **
-
Wie können Trainingsdaten effektiv genutzt werden, um maschinelles Lernen zu verbessern? Was sind die besten Methoden zur Beschaffung und Verwaltung von Trainingsdaten für KI-Systeme?
Trainingsdaten können effektiv genutzt werden, indem sie in ausreichender Menge und Vielfalt gesammelt werden, um das Modell zu trainieren. Zudem ist es wichtig, die Daten zu bereinigen und zu kennzeichnen, um sicherzustellen, dass sie von hoher Qualität sind. Schließlich sollte das Modell regelmäßig mit neuen Daten aktualisiert werden, um die Leistung kontinuierlich zu verbessern. Die besten Methoden zur Beschaffung und Verwaltung von Trainingsdaten für KI-Systeme sind die Nutzung von Datenbanken, Crowdsourcing-Plattformen und Web-Scraping-Tools, um eine große Menge an Daten zu sammeln. Zudem ist es wichtig, die Daten zu kategorisieren, zu kennzeichnen und zu **
-
Wie können Trainingsdaten effektiv genutzt werden, um maschinelles Lernen zu verbessern?
Trainingsdaten sollten vielfältig und repräsentativ sein, um das Modell auf verschiedene Szenarien vorzubereiten. Zudem ist es wichtig, die Daten vorab zu bereinigen und zu normalisieren, um Rauschen zu reduzieren. Schließlich sollte das Modell regelmäßig mit neuen Daten aktualisiert und überwacht werden, um die Genauigkeit und Leistung kontinuierlich zu verbessern. **
Ähnliche Suchbegriffe für Trainingsdaten
-
Konkurrenz und Transfer, Fachbücher von Bettina BraunDas Verhältnis zwischen Preussen und Österreich im 18. Jahrhundert wurde häufig als konfrontativ oder gar als Systemgegensatz geschildert. Die Beiträger des Bandes gehen hingegen von Konkurrenz als einem dynamischen und flexiblen Konzept aus. Sie legen dar, wie beide Mächte in der monarchischen Herrschaftspraxis, im Militär, in der Finanzverwaltung, der Religionspolitik und im Volksschulwesen Konzepte des Gegners oder Dritter übernahmen oder unabhängig und parallel zu ähnlichen Lösungen fanden. Ausserdem zeigt der Band, auf welche Weise Österreich und Preussen in verschiedenen Bereichen der Reichspolitik und in ausgewählten Territorien miteinander konkurrierten.55,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Ausdauer-Henley - 46Macht das Rennen, seit 1839. Noch immer haftet dem Henley die Aura des ausdauernden Mannes an. Typisch sind der gerade Schnitt, inspiriert von den Ruderern der Regatta im englischen Henley¿on¿Thames, die beim Fassen des Ruders nirgends hängenbleiben wollten, sowie die halbe Knopfleiste und der angenehm anliegende Rundhalsausschnitt. Die unperfekte Rollkante setzt einen modernen Akzent. Gewirkt aus dichtem Baumwollstoff, der dem Shirt eine klare Kontur gibt.49,95 €*Versand: 6,95 €Sichere Weiterleitung zum Anbieter
-
Wie beeinflusst das Splitten von Trainingsdaten die Leistung von maschinellen Lernalgorithmen in Bezug auf Genauigkeit und Overfitting?
Das Splitten von Trainingsdaten in Trainings- und Testsets ermöglicht es, die Leistung eines maschinellen Lernalgorithmus zu bewerten, indem das Modell auf den Trainingsdaten trainiert und auf den Testdaten getestet wird. Dies hilft, die Genauigkeit des Modells zu bewerten, da es auf Daten getestet wird, die es zuvor nicht gesehen hat. Außerdem hilft das Splitten der Daten, Overfitting zu vermeiden, da das Modell auf unabhängigen Testdaten getestet wird, was dazu beiträgt, sicherzustellen, dass das Modell nicht zu stark an die Trainingsdaten angepasst ist. Durch das Splitten der Daten können wir also die Genauigkeit des Modells bewerten und sicherstellen, dass es nicht überangepasst ist. **
-
Wie beeinflusst das Splitten von Trainingsdaten die Leistung von maschinellen Lernalgorithmen in Bezug auf Genauigkeit und Overfitting?
Das Splitten von Trainingsdaten in Trainings- und Testsets ermöglicht es, die Leistung eines maschinellen Lernalgorithmus zu bewerten, indem die Genauigkeit auf einem unabhängigen Datensatz gemessen wird. Dies hilft, Overfitting zu vermeiden, da der Algorithmus auf Daten getestet wird, die er während des Trainings nicht gesehen hat. Ein zu kleines Trainingsset kann zu Overfitting führen, während ein zu großes Trainingsset zu einer schlechten Generalisierung führen kann. Das richtige Verhältnis zwischen Trainings- und Testdaten ist entscheidend, um die Leistung des Algorithmus zu optimieren. **
-
Was sind Trainingsdaten und warum sind sie für maschinelles Lernen so wichtig?
Trainingsdaten sind Beispieldaten, die verwendet werden, um ein Modell im maschinellen Lernen zu trainieren. Sie bestehen aus Eingabe- und Zielvariablen, die dem Modell helfen, Muster zu erkennen und Vorhersagen zu treffen. Ohne Trainingsdaten könnte das Modell keine Zusammenhänge lernen und wäre nicht in der Lage, genaue Vorhersagen zu treffen. **
-
"Was sind Trainingsdaten und wie werden sie in der künstlichen Intelligenz verwendet?"
Trainingsdaten sind Daten, die verwendet werden, um ein künstliches Intelligenzmodell zu trainieren. Sie bestehen aus Eingabe- und entsprechenden Ausgabedaten, die dem Modell helfen, Muster zu erkennen. Die Trainingsdaten werden verwendet, um das Modell zu optimieren und es in die Lage zu versetzen, Vorhersagen oder Entscheidungen zu treffen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.